bezoekadres Universiteit Utrecht, Faculteit Geesteswetenschappen
Trans 10
3512 JK Utrecht
Nederland
Ik onderzoek hoe computers met taal leren omgaan.
Mijn groep bouwt het soort AI dat in chatbots als ChatGPT zit, en we vragen ons af:
kan deze technologie groener, opener over waar haar antwoorden vandaan komen,
en beter te reguleren door de samenleving?
Hieronder vind je mijn onderzoek, projecten, software en de mensen met wie ik werk.
Voor het formele overzicht, zie mijn CV en
publicatiepagina.
Kortere, minder gepolijste gedachten staan op mijn blog.
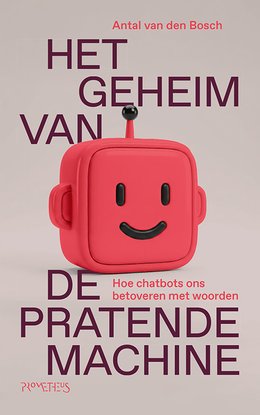
Meer informatie en bestellen op de pagina van de uitgever.
De officiële boekpresentatie, georganiseerd door het Centre for Digital Humanities van de Universiteit Utrecht, vindt plaats op woensdag 28 oktober 2026 in Bibliotheek Utrecht (Neude 11), 16:00 uur.
Nieuwe publicatie: geheugengebaseerd speculatief decoderen
Bij speculatief decoderen genereert een groot taalmodel sneller tekst doordat
een klein “conceptmodel” alvast vooruit gokt. In dit artikel is dat conceptmodel
Olifant, ons geheugengebaseerde model, en geen neuraal netwerk. Op juridische tekst
wordt het genereren tot 2,4× sneller en kost het 2,5× minder energie per woord,
met precies dezelfde uitkomst. De animatie van drie minuten hieronder laat zien hoe het werkt
(Engels gesproken).
Towards Green Text Generation: Memory-Based Speculative Decoding.
Antal van den Bosch. In de Proceedings of INLG 2026, pp. 472-482.
Code: github.com/antalvdb/olifant-speculative.
Waar ik aan werk
In de kern draait mijn onderzoek om één misleidend simpele taak:
het voorspellen van het volgende woord. Dat is de truc achter elk modern taalmodel,
inclusief ChatGPT, en een goede volgend-woord-voorspeller blijkt verrassend veel taal,
redeneervermogen en cultuur te bevatten.
Mijn werk combineert machine learning, computers laten leren uit voorbeelden,
met taal. Onze modellen zijn op zichzelf nuttig, en raken ook aan vragen in de
taalkunde, psychologie en neurowetenschap over hoe mensen met taal omgaan. Ik werk vooral
graag aan projecten over de grenzen van disciplines heen.
Olifant: een lichter alternatief voor Generatieve AI
Chatbots als ChatGPT en Claude draaien op Transformers, een krachtige maar
energieverslindende architectuur. Met Maarten van Gompel, Peter Berck, Ko van der Sloot
en een groeiend team studenten breng ik een ouder, simpeler idee terug,
memory-based taalmodellen, en laten we zien dat dat veel van hetzelfde werk
kan doen voor een fractie van de energie.
Het trainen van onze modellen kost ruwweg 1.000× minder elektriciteit
dan het trainen van een vergelijkbare Transformer, en het beantwoorden van vragen kost
10 tot 100× minder. Ze schalen goed op met meer data en kunnen, anders dan
gangbare taalmodellen, laten zien op welke trainingsvoorbeelden een antwoord gebaseerd is.
Dat maakt hun gedrag controleerbaar en navolgbaar.
We publiceerden de software als Olifant,
beschreven de methode in een paper,
en delen demo's en downloadbare modellen.
Uit het Olifant-paper: geschatte CO2-uitstoot
(gemeten met CodeCarbon) van taalmodellen die de volgende woorden voorspellen in een tekst
van 500.000 tokens. De stippellijnen tonen alledaagse uitstoot ter vergelijking: een wasbeurt,
tien minuten autorijden, een liter melk. Twee van onze modellen blijven ruim onder de wasmachine;
grotere GPT-achtige systemen lopen steil op.
Probeer het zelf: voor elke zin die je intikt laat de demo hieronder zien op welke
eerdere voorbeelden Olifant zich baseert om het volgende woord te voorspellen. Er is ook een
demo voor tekstgeneratie
en een verzameling Olifant-modellen
op Hugging Face.
De cursus introduceert de Transformer, de T in GPT en de architectuur die het
AI-landschap sinds de komst van ChatGPT eind 2022 heeft veranderd. In de kern doet hij
maar één ding: het volgende woord voorspellen. Hoe slaagt zo'n voorspeller
dan voor examens, of lijkt hij te redeneren? Waar gaat het mis, en waar gaat het veld heen?
Oraties & publieke lezingen
Pas benoemde hoogleraren in Nederland en België geven traditioneel een publieke oratie.
Ik deed dat drie keer: in Tilburg (2008), in Nijmegen (2012) en in 2023 in Kortrijk, als
bekleder van de Francqui Leerstoel 2023 over Taal en AI
aan KU Leuven KULAK.
Alle drie cirkelen rond één idee: het volgende woord goed voorspellen brengt
je verbazingwekkend ver. Al in 2008 betoogde ik dat volgend-woord-voorspellers beter blijven
worden met meer trainingstekst, waarbij elke vertienvoudiging van de data een stabiele,
voorspelbare winst in nauwkeurigheid oplevert. Die observatie
(de Wet van Heaps) ligt stilletjes
aan de basis van de huidige groei van grote taalmodellen.
Het volgende woord, oratie, Tilburg University, 10 oktober 2008. Een paar animaties op YouTube; hieronder een korte met Nederlandse zinnen waarin het volgende woord vrijwel vastligt.
Aanstellingen en lidmaatschappen
Sinds september 2022 ben ik faculteitshoogleraar aan de
Faculteit Geesteswetenschappen
van de Universiteit Utrecht.
Sinds 2026 ben ik vice-decaan onderzoek en impact van die faculteit.
Tussen juli 2023 en juni 2026 was ik voorzitter van het NWO-domein Sociale en Geesteswetenschappen
en was ik lid van de raad van bestuur van NWO.
Onze projecten leveren ook software op, waar mogelijk als open source.
Sommige pakketten draaien als webservices
met een vriendelijke interface, en een aantal is opgenomen in nationale en Europese
onderzoeksinfrastructuren.
Een paar highlights:
Olifant: het memory-based taalmodel
uit de linkerkolom. Het bouwt voort op een lange reeks eerdere systemen, waaronder
WOPR (2010), dat met veel minder data en veel kleinere computers al volgende woorden voorspelde.
Met Peter Berck, Maarten van Gompel, Ko van der Sloot, Teun Buijse en Ainhoa Risco Paton.
Frog: een veelzijdige analysetool voor
Nederlandse tekst die woordsoorten, stamvormen en zinsstructuur bepaalt.
Met het Frog-ontwikkelteam.
T-Scan
(ook als webtool): analyseert Nederlandse tekst
op kenmerken die met leesbaarheid samenhangen.
Timbl: de Tilburg Memory-Based Learner,
de klassieke toolkit onder een groot deel van ons memory-based werk.
Met Ko van der Sloot, Walter Daelemans en Jakub Zavrel.
Meer software en digitale infrastructuur
Taaltechnologie
Valkuil.net en
Fowlt.net: contextgevoelige spellingcorrectors
voor het Nederlands en het Engels.
Colibri Core: efficiënte n-gram- en skip-gram-modellen. Met Maarten van Gompel.
Mbt: memory-based
woordsoort-tagger. Met Ko van der Sloot, Jakub Zavrel en Walter Daelemans.
WOPR genereert in 2010 "woordsla": een kleine voorloper van ChatGPT.
Digitale onderzoeksinfrastructuur
CLARIAH: Common Lab Research Infrastructure for the Arts and Humanities.
Nederlab: gedigitaliseerde Nederlandse teksten van de middeleeuwen tot nu in één doorzoekbare omgeving (NWO).
FutureTDM: een Horizon 2020-actie over text and data mining.
TwiNL: een Netherlands eScience Center-project met Erik Tjong Kim Sang.
ISHER: Integrated Social History Environment for Research.
Eerdere projecten
Toon onderzoeksprojecten die ik eerder leidde of mede-leidde
ADNEXT: Adaptive Information Extraction over Time, onderdeel van het COMMIT-programma.